
SE-Fab V-Trace:让每个突变体都有迹可循
TECHNICAL REPORT · SE-Fab V-TRACE
高通量酶筛能够快速获得大量突变体的活性读数,传统做法只选择有限的top N高活性突变体进行测序,那些低活性、无活性孔位的真实序列身份仍不明确。研究人员难以进一步判断:活性差异对应哪些突变,哪些异常结果值得复核?
为补齐序列身份验证环节,涌生智能推出SE-Fab Variant Trace(SE-Fab V-Trace)突变体追溯验证技术方案。该方案以双端Barcode靶向扩增子测序为核心,结合板孔映射、逐孔序列分析和关键质粒全长测序,在已有自动化酶筛流程上增加可核查的分子身份依据,支持候选筛选、实验质量复核和后续数据驱动的酶进化。其中,SE-Fab覆盖突变体构建、转化、单克隆挑取、孔板培养、表达裂解与高通量酶活检测。Variant Trace(V-Trace)在这一基础上增加靶区序列鉴定环节,将实测序列与来源孔板、功能数据进行关联。
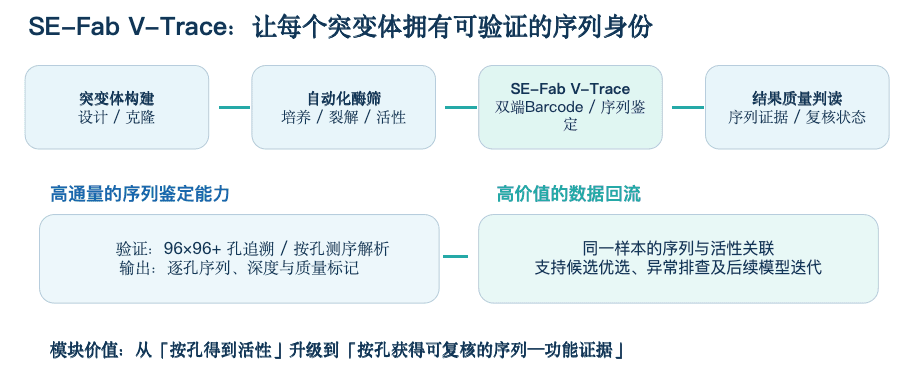
图1|SE-Fab V-Trace在自动化酶筛中的位置与价值
01|为什么高通量酶筛还需要序列验证?
传统定向进化通常先完成文库筛选,再对少数表现优异的克隆开展Sanger测序。该方式适合验证重点候选体,但当筛选规模扩展到多个96乃至384孔板时,逐克隆测序需要更多样本处理与测序操作。SE-Fab V-Trace 采用双端 Barcode 组合编码与混合建库测序,将批量突变体的序列信息还原至对应板孔,为高通量酶筛提供规模化的序列验证能力。
对于数据驱动的蛋白工程,重要的不仅是找到高活性突变体,低活性或无活性样本同样具有分析价值。 明确这些样本的序列信息后,研究人员可在相同检测条件下比较不同突变体表现,识别值得继续探索的替换或组合,也能判断哪些改造方向需要谨慎采用。前提是序列身份清楚、功能数据可信,并且保留相应的突变背景与实验条件。因此,逐孔序列验证的关键并不是增加测序数量,而是让筛选记录有对应的序列身份,便于选择候选、排查异常,从而扩展后续可分析的设计空间。
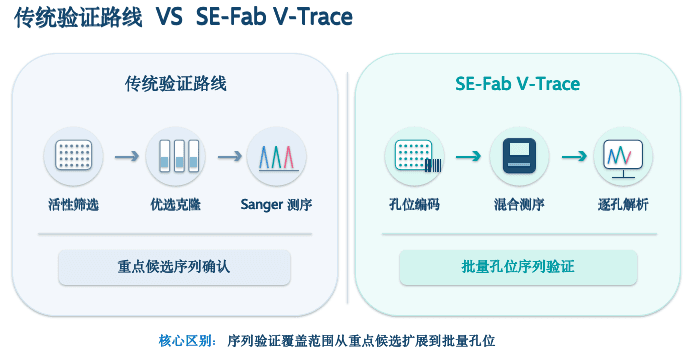
图2|传统 Top N 测序与逐孔测序的序列覆盖差异
02|SE-Fab升级:把序列信息接入样本记录
SE-Fab现有流程包括突变体构建、转化、单克隆挑取、孔板培养、表达裂解与高通量酶活检测。SE-Fab V-Trace在孔板培养环节,可取用少量菌液进行V-Trace高通量混合建库测序,该步骤与SE-Fab现有后续环节可并行开展,不需要额外的样本处理流程。获得的逐孔测序结果与活性检测数据可进行关联分析。
技术架构包含三个互补层级:样本层,实体样本标识记录样本、板孔及转移信息,记录的是 ' 样本从哪来 ';测序层,双端 Barcode 组合负责把混合测序的数据映射回具体板号和孔位;分析层,即设计版本、实验批次、参考序列、分析批次及表型记录,关联的是 ' 这组数据用什么参数算出来的 '。
SE-Fab V-Trace 将“样本从哪里来、实测目标区域序列是什么、功能表现如何”纳入同一证据链,为结果核查和异常定位提供清晰路径。
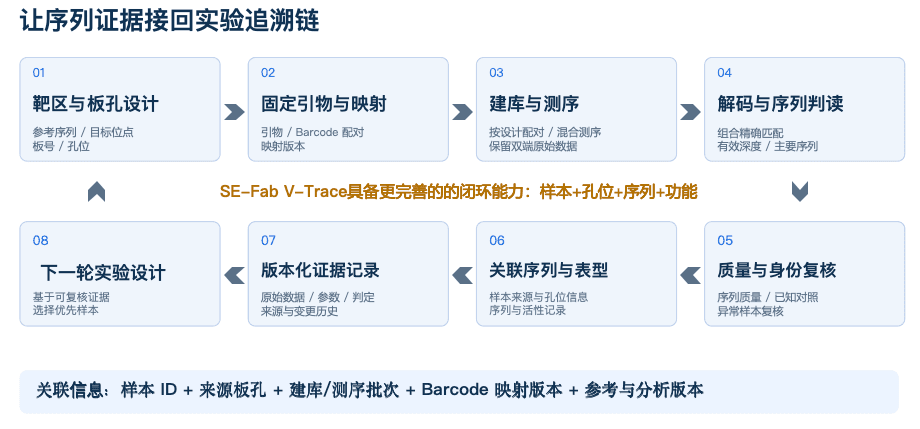
图3|SE-Fab V-Trace序列追溯闭环总览
03|技术原理:两步PCR与双端Barcode编码
目标区域与引物设计
首先根据目标突变位点确定参考序列、扩增范围、阅读框及与全长蛋白的坐标关系。方案采用内外两组引物的功能解耦设计:内引物负责目标区域特异性扩增并引入通用序列,外引物携带双端 7 nt Barcode 与测序兼容序列,使不同板孔的扩增子混合测序后仍可按 Barcode 独立归属。该两步 PCR 与双端 Barcode 策略参考 Wittmann 等人的研究方法 [1],并结合自动化孔板场景完成了工程化落地。
这种策略适合短片段靶区与指定突变位点的高通量验证;需要评估全长基因或载体完整性时,可进一步使用质粒全长测序。
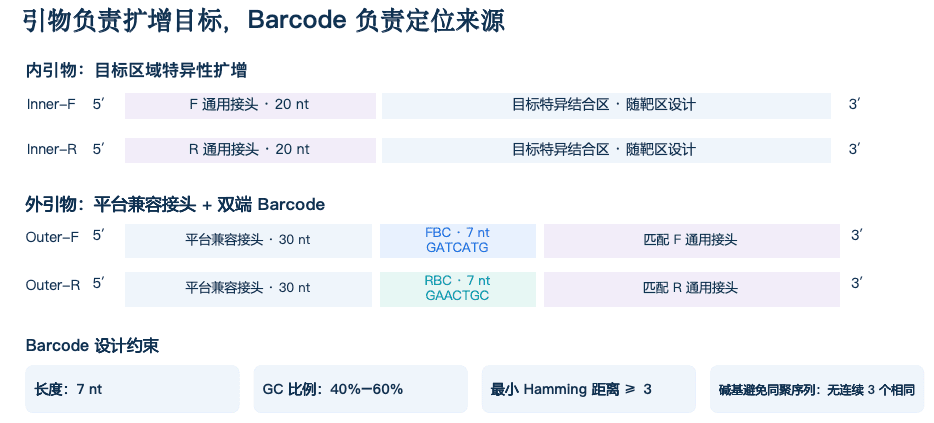
图4|内外引物结构及双端Barcode功能分工
面向自动化孔板的Barcode组合优化
当前方案设计使用96条正向和96条反向Barcode,每条长度为7 nt,理论配对组合为9,216种。理论上,根据突变体库的大小,可以自行调整barcode长度,相关引物可在已发布的引物设计平台PrimeGen进行设计[2]。第一块 96 孔板采用正反向同位置配对,第二块板保持正向 Barcode 来源不变、反向 Barcode 来源按列循环移动,使相同孔位在不同样品板上具有不同组合身份。按照设计规则,可配置12块96孔板、合计1,152个不同孔位组合。
图5为96 x 96 barcode组合唯一性验证示例。当突变体库容量更高时,可设计增加barcode长度,以适配更高通量的孔板形式。
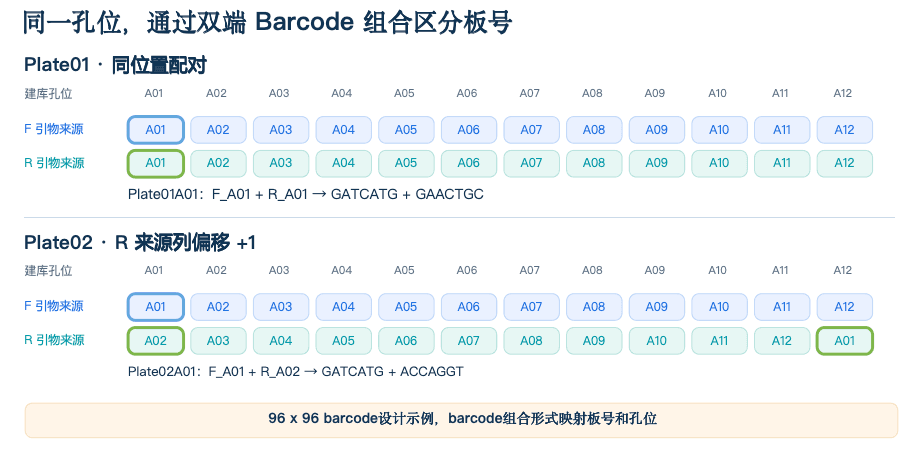
图5|双端Barcode映射板号和孔位
从混合测序数据恢复到逐孔序列
测序后依据正反向Barcode组合进行精确解码确保孔位归属准确,再进行参考序列比对、目标位点判读和质量分析。
逐孔分析报告包含主要序列、可分辨的混合序列、有效覆盖深度、主要序列频率及异常标记。对于随机或饱和突变文库,系统直接输出实测变体身份;对于指定构建任务,自动完成设计序列与实测序列的比对确认。
04|实测验证:从混合文库还原逐孔序列证据
为验证整套方案在真实突变文库中的工作能力,选取目标蛋白第 485、486 位氨基酸的双位点饱和突变文库,完成两块 96 孔板、共 192 个孔位的双端 Barcode 建库与逐孔生信解析。验证覆盖了板孔编码、混合测序、读段归属、靶区比对及逐孔质量分析的完整链路。
此次实验获得 11,419,483 对双端 150 bp 测序读段,板1 与 板2 的 Q30 分别为 95.30% 和 94.24%。根据对应的组合映射,192 个设计孔位均获得 Barcode 分配记录;混合数据被还原为可追溯至来源板孔的独立序列信息。全体孔位的有效比对读对数中位数为 25,139.5 对,显示该流程已具备面向成批突变体的序列解析能力。
| 验证项目 | 验证结果 |
|---|---|
| 测序数据 | 11,419,483对双端150 bp读段 |
| 测序质量 | plate1 Q30 95.30%, plate2 Q30 94.24% |
| Barcode分配 | 192/192孔完成 Barcode 解码与孔位归属 |
| 当前质控 | 181/192 孔通过逐孔质量判定(PASS),序列身份可用于后续分析 |
| 有效比对深度 | 全孔位有效比对读对数中位数约 2.5 万对;11 孔无有效比对读对 |
首轮192孔文库验证中,全部孔位均获得Barcode分配记录,其中181孔检出有效比对读段,占比94.3%;其余11孔未获得有效比读段。当前统计以有效比对读对数大于0作为检出判定标准,用于评估逐孔测序数据的获取情况。
通过逐孔测序深度分布,可以直观识别不同孔位的数据覆盖情况,为研究人员筛选候选样本、安排异常孔位复核及优化扩增与建库流程提供依据。对于混合序列,根据活性数据评估是否重新挑取单克隆进行复核;对于低深度和未检出有效比对读段的孔位,可结合样本模板、引物匹配、扩增和建库情况开展排查,必要时进行独立测序复核。
针对未检出有效比对读段的孔位,选取Plate01-A12和Plate02-A12进行Sanger测序复核,发现两个样本在目标蛋白第485位对应区域均存在长片段插入,可能影响靶向扩增及参考序列比对。这一结果展示了逐孔质量分析与独立测序复核的互补价值,为异常样本识别及后续实验优化提供了依据。
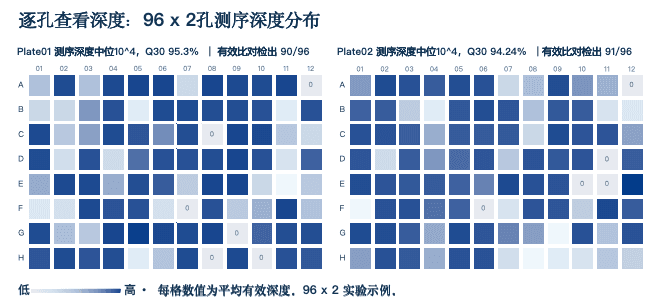
图6|两块 96 孔板逐孔有效测序深度分布
05|双层序列验证:兼顾通量与质粒测序完整性
SE-Fab V-Trace 将孔位级靶向扩增子测序与单克隆级质粒全长测序相结合:前者重点确认批量筛选样本的目标位点序列,后者为关键候选体提供目的基因、调控元件和载体骨架的更广范围核验。两类证据分别服务于常规高通量追溯与关键节点确认。
| 技术层级 | 核心用途 | 覆盖范围 |
|---|---|---|
| 靶向扩增子测序 | 逐孔突变身份鉴定、混合克隆检测、文库组成分析 | 覆盖全部 96 孔板的设计靶区 |
| 质粒全长NGS | 关键克隆全长确认、靶区外变异检测、骨架完整性验证 | 按需触发,覆盖基因全长与载体骨架 |
在独立的质粒全长测序示例中,4个质粒测试样本的报告均显示完成7,631 bp参考质粒的全长组装结果,与参考序列比对的一致性为 100%,未检出SNP、Indel或结构变异。质粒全长测序已在标准样本上完成全流程验证(7,631 bp 全长组装、100% 一致性),可作为关键单克隆构建体的进一步核验手段。
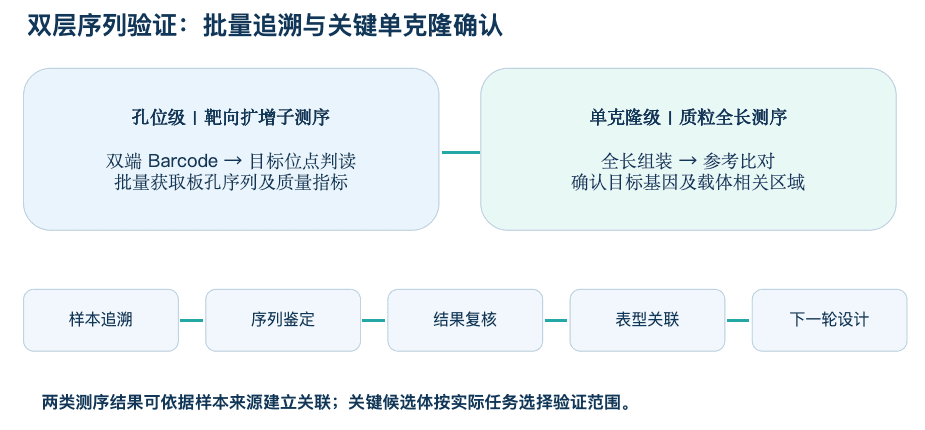
图7|靶向测序与质粒全长测序的双层互补验证
06|从序列追溯到数据资产
SE-Fab V-Trace 的价值不仅在于识别突变体的序列信息,更在于将序列验证结果转化为可追溯、可复用的实验数据,为工艺优化和下一轮酶进化设计提供依据。
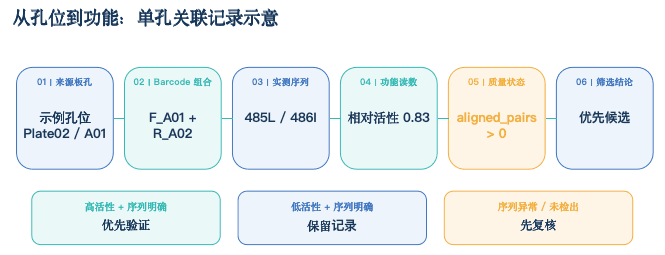
图8|同一孔位同时关联:板孔来源、Barcode 解码、序列信息、活性读数与质量状态
从序列异常追溯到工艺优化。 对于低覆盖、无有效测序信息的样本,可结合扩增、建库及读段分配来定位排查方向;对于存在混合序列的孔位,可关联克隆来源记录开展复核;对于关键候选突变体,则可通过质粒全长测序进一步确认构建完整性。本次文库验证中,针对部分低深度孔位开展的 Sanger 复核与独立实验排查,也为后续优化样本质量、引物匹配及文库构建流程提供了参考。
从序列—功能关联到数据资产积累。 高活性突变体是酶工程的重要筛选目标,而经过可靠序列鉴定的低活性、无活性突变体同样具有研究价值。通过关联真实序列与功能表现,可以更全面地分析氨基酸替换效应、位点间相互作用及酶的功能边界。对于序列身份不明确、存在混合克隆或质量不足的样本,系统保留其原始记录与质量状态,确保后续分析建立在可靠的数据基础上。
在此基础上,SE-Fab V-Trace 将突变体序列、实验孔位、功能表型、质量指标及分析版本形成结构化关联,支持文库覆盖分析、候选突变体筛选和异常样本复核,并为后续实验优化及AI辅助酶设计提供数据依据。
作为SE-Fab技术体系的重要组成部分,V-Trace与SE-Fab既有Scientific Trace形成互补:前者提供突变体的分子序列证据,后者记录科研任务的执行过程与判断依据,共同为可追溯、可迭代的智能科研流程提供支撑。
07|结语:让每个突变体都有迹可循
SE-Fab V-Trace 的升级价值,在于让样本来源、实测序列、活性读数与质量状态形成一条可回查的证据链 —— 候选为何被保留、记录如何解读、孔位是否待复核,每个判断都有据可依。经核查的记录,将成为复核实验与下一轮设计的直接依据。
让每一个突变体,都被看见、可验证、可追溯。
合作共建
让每个突变体都有迹可循,是积累可复用的序列—功能数据的重要一步。我们期待与酶工程、高通量筛选及AI蛋白设计团队开展合作,在更多真实文库和筛选任务中,共同完善逐孔序列验证与功能数据关联,探索这些记录如何支持候选筛选、异常复核和下一轮实验设计。
商务合作:pr@genoria.ai
欢迎介绍你的研究方向、筛选场景,以及希望共同解决的问题。
加入我们
从序列与功能的关联出发,我们希望让实验数据沉淀为AI可以学习和利用的科学经验,连接分子设计、实验验证与持续迭代,推动科学发现走向规模化。如果你也期待探索AI与生命科学的交汇,参与构建能够持续积累经验的自进化实验室,欢迎加入涌生智能,与我们共同推进 Scale Agentic Discovery——规模化AI科学发现。
加入我们:hr@genoria.ai
欢迎附上简历或项目经历,告诉我们你希望参与解决的技术问题。
参考文献
- Wittmann, B. J., Johnston, K. E., Almhjell, P. J., Arnold, F. H. evSeq: Cost-Effective Amplicon Sequencing of Every Variant in a Protein Library. ACS Synth. Biol. 11(3), 1313–1324 (2022). https://doi.org/10.1021/acssynbio.1c00592
- Wang, Y., Hou, Y., Yang, L., et al. Accelerating primer design for amplicon sequencing using large language model-powered agents. Nat. Biomed. Eng. 10, 338–353 (2026). https://doi.org/10.1038/s41551-025-01455-z
- Genoria. SE-Fab: Self-Evolving Foundry. https://www.genoria.ai/blog/se-fab-self-evolving-foundry
- Genoria. Scientific Trace: 让自进化实验室的判断有据可查. https://www.genoria.ai/blog/scientific-trace